Contexte
Les médias numériques grand public se dégradent à l’échelle de quelques années. Les SSD non alimentés perdent leur charge, les disques optiques se délaminent, les formats tombent en désuétude et les comptes sont fermés. Le papier peut durer des siècles, ne nécessite aucune électricité et peut être vérifié à l’œil nu. La question est de savoir quelle quantité d’information une feuille A4 ordinaire peut contenir si elle doit encore pouvoir être relue de façon fiable avec un scanner à plat standard, sans matériel spécialisé.
Le problème est difficile car le canal impression-numérisation est bruité de plusieurs manières à la fois. Le toner s’étale et forme des amas, la densité varie sur la page, et les scanners introduisent rotation, mise à l’échelle anisotrope, entraînement irrégulier du papier, flou, vignettage et gamma. Le papier se déforme aussi de façon non linéaire : à la densité visée, un étirement de 0,2 % décale la grille d’environ trois cellules. Les codes 2D courants comme QR et DataMatrix sont conçus pour la robustesse plutôt que pour la densité. Une archive à long terme doit en outre rester décodable lorsque les logiciels actuels auront disparu.
Approche
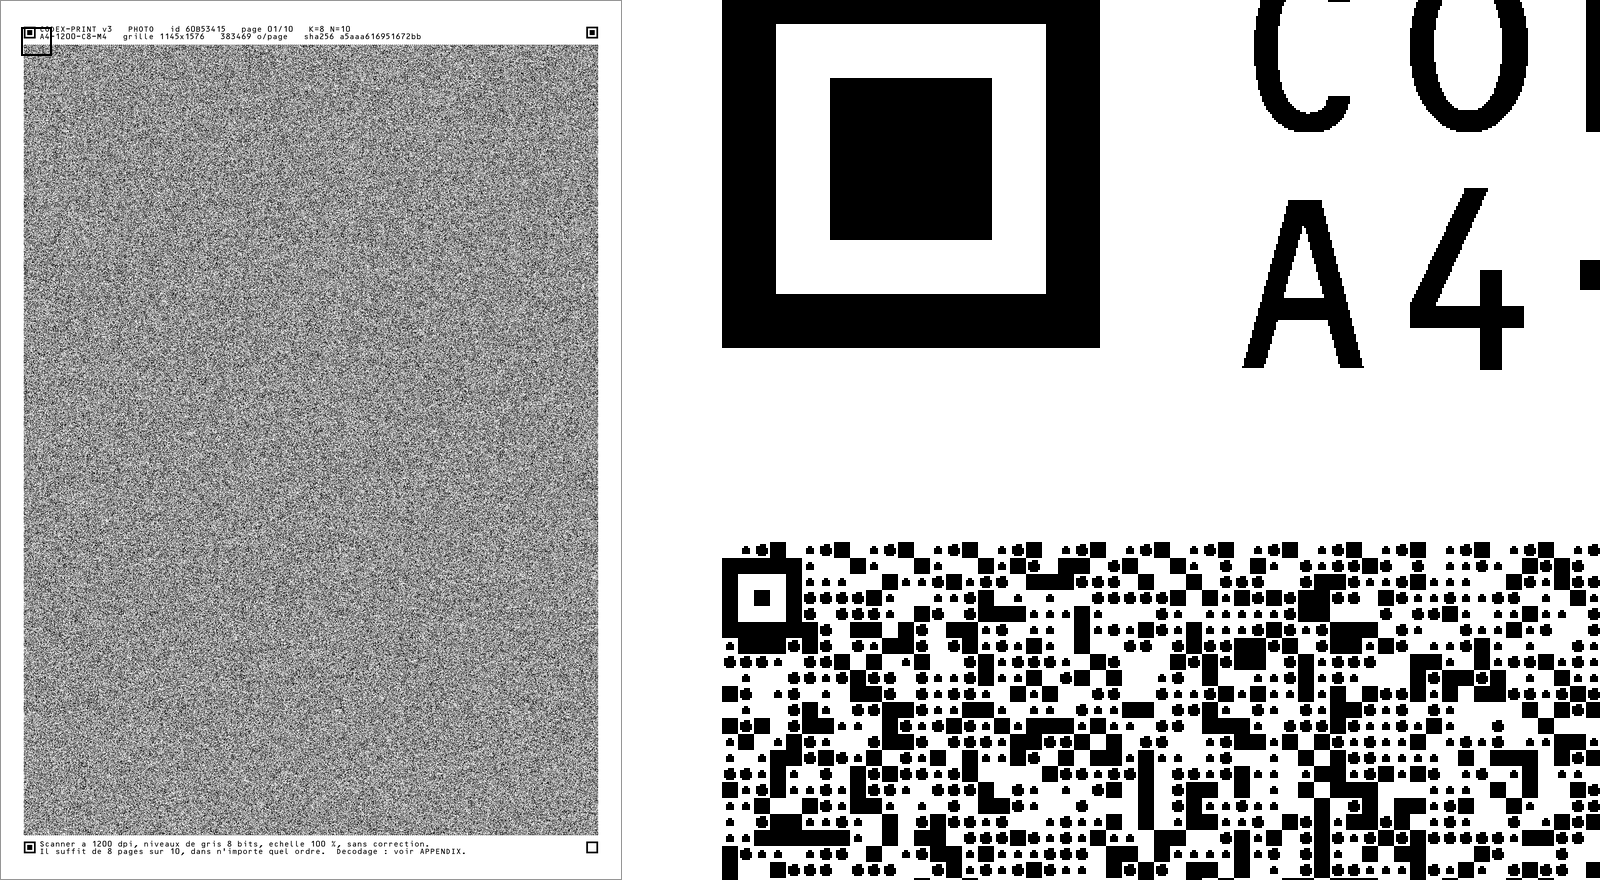 À gauche : la page 1 sur 10 de l’archive photo, telle qu’envoyée à l’imprimante (A4, 1200 dpi, une grille de 1 145 × 1 576 cellules), réduite. À droite : le coin supérieur gauche encadré, à la résolution de l’imprimante (environ 10 × 9 mm, chaque point d’imprimante dessiné en 2 × 2 pixels) : le repère d’angle plein, le début du bandeau d’en-tête et les premières cellules de données. Chaque cellule mesure 8 × 8 points (0,169 mm) et son nombre de points encrés code l’un des 4 niveaux. Le carré situé au coin de la grille est un marqueur d’alignement.
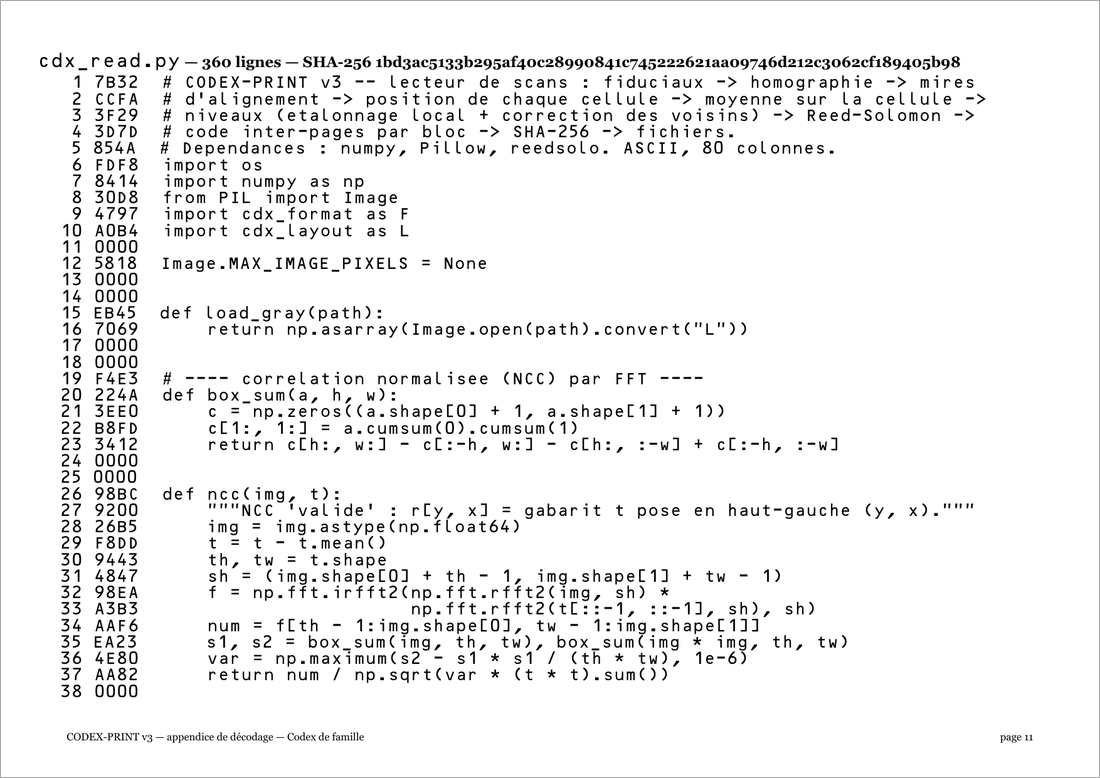 Une page de l’annexe imprimée (page 11 sur 30) : le début de
cdx_read.py (360 lignes), composé en OCR-B. Chaque ligne porte son numéro et son CRC-16 : une ligne mal relue par l’OCR peut ainsi être repérée et vérifiée à la main.
Méthodes
- Cellules multiniveaux plutôt que modules binaires. Chaque cellule porte 2 bits. Les cellules sont dessinées sous forme de points groupés à la résolution native de l’imprimante, de sorte que le pilote n’effectue aucun tramage et ne produit aucun moiré.
- Récupération de la géométrie par étapes. Quatre repères d’angle, dont l’un est creux pour fixer l’orientation, donnent une homographie globale. Des marqueurs d’alignement répartis sur la page absorbent ensuite l’étirement local et non linéaire du papier.
- Lecteur auto-calibré. Le décodeur estime les niveaux de gris imprimés et l’ombrage spatial à partir de structures de calibration présentes sur chaque page ; il ne dépend donc pas des réglages de points de l’imprimante.
- Contrôle d’erreurs à deux niveaux, un code produit. Reed–Solomon et CRC-32 à l’intérieur de chaque page corrigent les erreurs aléatoires et en rafale, comme les taches et les rayures. Un code à effacement MDS de Cauchy entre les pages, décodé bloc par bloc, permet à K pages quelconques parmi N de reconstruire une archive.
- Dégradation progressive. Si le contrôle SHA-256 échoue, le décodeur extrait malgré tout chaque fichier complet situé avant la zone endommagée.
- Archive autodescriptive. Une annexe imprimée contient la spécification du format, une procédure de lecture et le code source complet du décodeur en OCR-B, avec un numéro de ligne et un CRC-16 sur chaque ligne. Le décodeur ne nécessite que NumPy, Pillow et reedsolo. Le texte utilise DEFLATE (zlib), qui peut être réimplémenté en quelques centaines de lignes, plutôt que LZMA, plus performant.
- Prototype antérieur (
codex_proto/). Cette version explorait plusieurs supports physiques : papier, acier inoxydable gravé au laser, plaques en taille-douce et images de microfilm. Elle utilisait des cellules de 2 à 16 niveaux, des pages de parité de type fontaine, des lecteurs de niveaux de gris à base de MLP, un calculateur optique imprimé pour la lecture des microfilms, ainsi qu’une réduction des médias avec pertes (codage paramétrique de la voix, codage des photos par résidus d’ondelettes).
Résultats
Tous les chiffres ci-dessous proviennent uniquement de simulations. Le logiciel modélise les défauts laser (flou du spot, grain du toner, engraissement du point, effet de bandes, densité non uniforme, papier texturé), les défauts du scanner (rotation de ±1,2°, échelle x/y de ±0,3 %, oscillation de l’entraînement, flou, vignettage, bruit, gamma 2,2), des taches de café, des rayures et une page volontairement perdue par archive. Aucun essai physique d’impression et de numérisation n’a encore été réalisé.
- Charge utile nette : 383 469 octets par page A4, soit environ 59 bits/mm².
- De bout en bout : 46 pages sur 50 ont été numérisées et les 4 archives sur 4 ont été restaurées à l’identique, octet pour octet (photo, vidéo, voix, texte). Aucun mot de code Reed–Solomon n’a échoué et aucun bloc inter-pages n’a été perdu.
- Taux d’erreur : les pages propres ont nécessité la correction d’environ 0,007–0,008 % des octets. Les pages tachées et/ou rayées en ont nécessité au plus 0,90 %.
- Taille des archives : photo 2,86 Mo → 10 pages (8 de données + 2 de parité) ; vidéo (800×600, 24 s, MJPEG + PCM 16 kHz) 8,30 Mo → 25 pages ; voix 0,91 Mo → 5 pages ; texte 5,58 Mo → 10 pages.
- Texte : les Mémoires d’outre-tombe, dans le domaine public (5,43 millions de caractères), occuperaient 1 357 pages A4 composées. Encodées, elles tiennent sur 6 pages de données, soit un rapport d’environ 226. zlib compresse cette prose d’un facteur 2,62 et LZMA d’un facteur 3,58.
- Récupération partielle : une archive tronquée au quart de sa longueur a encore restitué 1,42 Mo des 5,58 Mo de texte.
- Robustesse du décodeur : le décodeur a également fonctionné sur des numérisations tournées de 90° et 180°, sur des numérisations à 600 dpi et sur des numérisations JPEG (q92).
- Taille du décodeur : 731 lignes de Python pour les modules du décodeur imprimé.
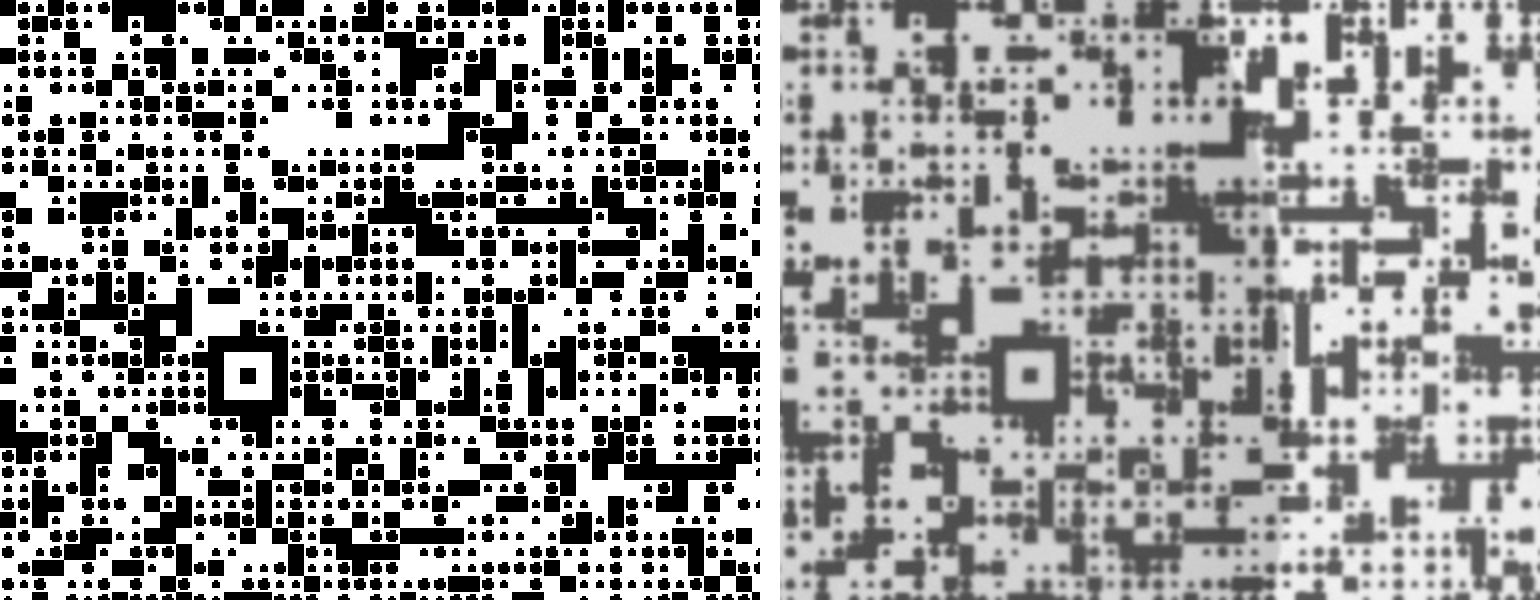 La même zone de la page photo (380 × 300 points, environ 8 × 6,4 mm), agrandie. À gauche : telle qu’encodée. À droite : après le canal impression-numérisation simulé, rééchantillonnée sur la grille de la page grâce à l’homographie des repères. L’étalement du toner, le flou et le bruit adoucissent les cellules, et le bord d’une tache de café simulée assombrit la partie gauche. Le lecteur calibre les niveaux de gris localement et distingue donc encore les quatre niveaux. Dans la simulation présentée ci-dessus, les pages tachées ou rayées ont nécessité la correction d’au plus 0,90 % des octets.
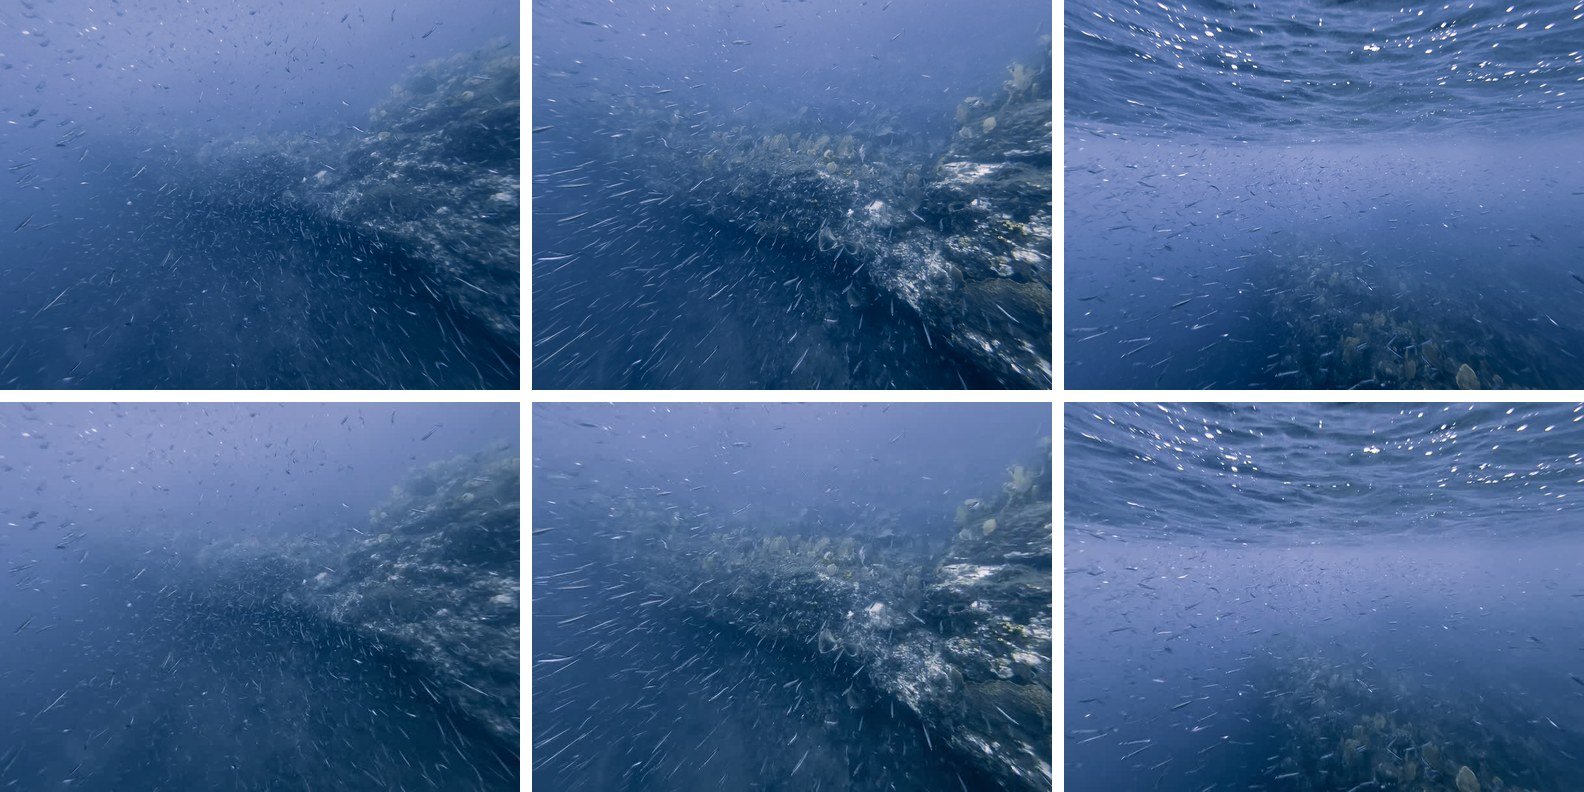 L’archive vidéo : un plan sous-marin (banc de poissons au-dessus d’un récif) servant de séquence de test. En haut : les images originales HEVC 3840 × 2880 à 3,2 s, 12,8 s et 16,0 s, réduites. En bas : les mêmes instants, décodés à partir des numérisations simulées des 25 pages (dont une volontairement perdue). Le canal papier lui-même ne perd rien : l’AVI restitué est identique, octet pour octet, à l’AVI archivé. Ce qui diffère de l’original, c’est la réduction faite avant l’impression (MJPEG 800 × 600, 12,5 images/s, son mono 16 kHz) pour que 24 s de vidéo tiennent en 8,30 Mo.
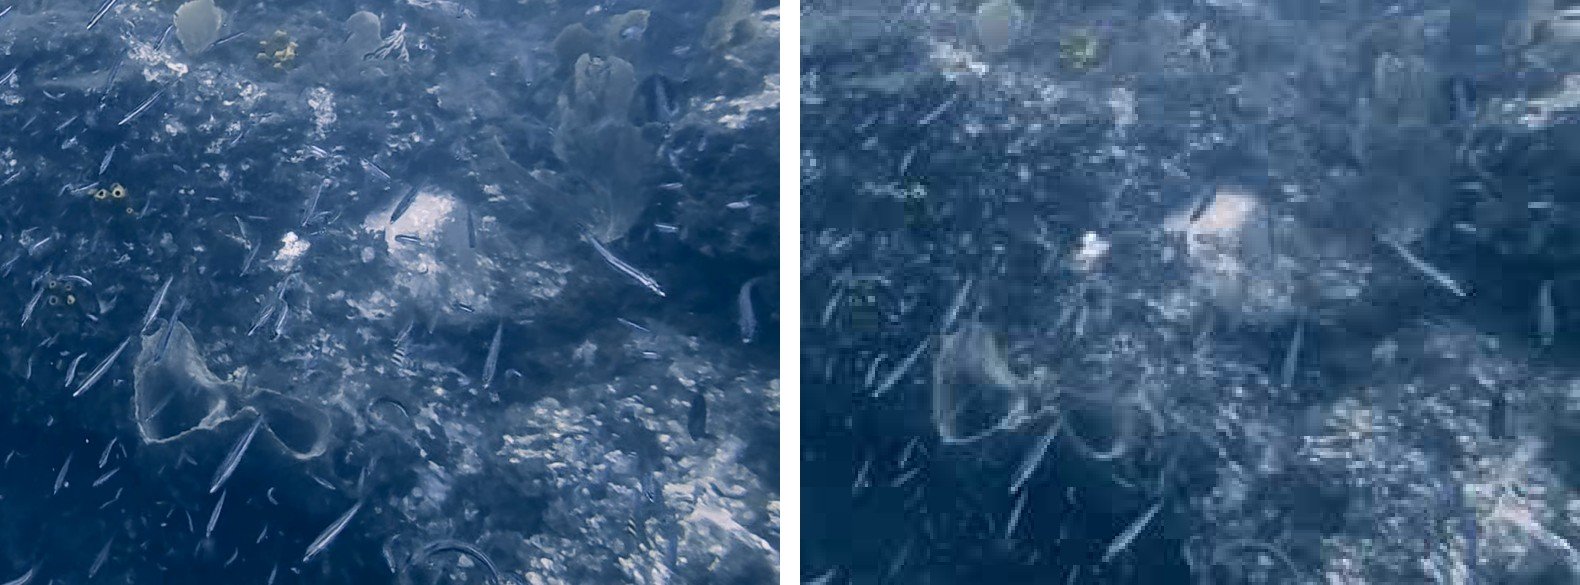 Gros plan sur l’image à 12,8 s. À gauche : une zone de 1 152 × 864 pixels de l’original, réduite. À droite : la zone correspondante de 240 × 180 pixels de l’image restituée, agrandie sans lissage. Les poissons et le récif restent reconnaissables. La texture fine et les nuances de couleur sont perdues, et des blocs MJPEG apparaissent. C’est le prix à payer pour faire tenir le plan en 25 pages.
Limites & suite
- Pas encore d’essai physique. Les motifs de points des cellules ont été ajustés en simulation. La prochaine étape est une impression réelle à 1200 dpi avec une numérisation à 1200 dpi, afin de les régler et de mesurer la marge d’erreur effective.
- Jeu de test restreint. La simulation couvre une seule exécution sur quatre archives. Un balayage en fonction de la sévérité des défauts, de la résolution de numérisation et du type de papier reste nécessaire.
- Propriétés physiques non mesurées. Le vieillissement à long terme du papier et du toner, ainsi que la faisabilité pratique de la relecture OCR du décodeur depuis le papier, n’ont pas été mesurés.
- Dépendance à une police. Le corps de texte de l’annexe repose sur une police système.
Stack technique
Python · NumPy · SciPy · Pillow · reedsolo · ReportLab · soundfile · ffmpeg · Tesseract (OCR-B)