Contexte
Des systèmes de production pour le rapprochement documentaire et l’OCR, développés pour des clients tels qu’un grossiste distributeur et un cabinet d’expertise comptable, ont laissé plusieurs bases de code résolvant chacune les mêmes sous-problèmes (routage des pages, réglage de l’OCR, extraction par LLM, comparaison de champs) avec leurs propres bogues. La bibliothèque d’atomes les consolide en un seul paquet. Sa question centrale est celle qui sous-tendait les systèmes d’origine : peut-on automatiser un contrôle documentaire de sorte qu’un humain puisse auditer et contester chaque verdict ? Extraire un champ ne suffit pas. Le système doit indiquer si deux documents concordent, pourquoi, et sur la base de quels éléments.
Approche
Tout est construit à partir d’atomes. Un atome a une seule responsabilité, des entrées et sorties typées, aucun état global et des dépendances injectées (client LLM, moteur OCR, stockage). Une chaîne de traitement est une composition d’atomes, soit écrite en code, soit déclarée sous forme de recette YAML validée au chargement, avant toute exécution.
Le catalogue
Les 459 atomes sont regroupés en 32 familles, un paquet Python chacune, rangées le long de
la chaîne de traitement : capter le monde, le comprendre, rapprocher et décider,
restituer, puis exploiter en production. Deux paquets supplémentaires les assemblent :
steps (77 étapes nommées et paramétrées) et recipes (chargement et validation des recettes YAML).
| Série | Famille | Atomes | Rôle |
|---|---|---|---|
| Socle | core | 25 | types pivots, chaîne de traitement, configuration, résilience (reprises, limites de débit), fichiers, concurrence |
| Capter | connect | 40 | HTTP résilient, boîtes aux lettres (Graph, IMAP), SFTP, OneDrive, source ERP en lecture seule, données ouvertes, piste d’audit |
google | 24 | Gmail, Sheets, Drive, Apps Script, avec exécution résiliente | |
web | 17 | robots web indépendants du pilote (Selenium, Playwright) : attentes, squelette à reprise, formulaires | |
pdf | 9 | texte natif positionné, décision d’OCR, rendu, pages, doublons | |
ocr | 9 | PaddleOCR avec réglages de production, EasyOCR | |
layout | 3 | géométrie de page : lignes, colonnes, redressement, rendu monospace | |
audio | 16 | transcription par morceaux, post-traitement des segments, recalage micro ↔ écran | |
vision | 32 | flux vidéo / RTSP, détection, suivi, profondeur, segmentation, calibration | |
vlm | 10 | lecture d’écran par modèle de vision-langage : détection de changement, localisation de libellés | |
geo | 11 | mesures géodésiques, position combinée de relevés GPS, filtrage par distance aux lignes, SQL spatial | |
calendar | 4 | jours fériés, jours et horaires ouvrés | |
| Comprendre | text | 32 | nombres et montants, dates, normalisation, champs par motifs, identifiants |
segment | 7 | pages → documents logiques, numéros de pièce typés, nature de page | |
classify | 12 | classement par nom de fichier, expéditeur, motifs pondérés, TF-IDF, visuel, LLM, cascades | |
llm | 24 | contrat indépendant du fournisseur, fournisseurs, pool, prompts, extraction structurée | |
anchor | 5 | champs et tableaux situés par rapport aux libellés imprimés, texte natif ou OCR | |
kb | 8 | base de connaissances tracée : journal d’événements validé, replié en index SQLite | |
| Rapprocher | match | 25 | EAN/GTIN, index, score multicritère, affectation optimale, résolution d’entités |
compare | 9 | comparateurs tri-états et explicables de champs, d’enregistrements et d’ensembles | |
check | 9 | contrôles génériques tri-états : totaux, TVA, balance, complétude, vraisemblance | |
reconcile | 12 | appariement d’ensembles, chaînes commande → livraison → facture, N-voies, lettrage, rapprochement bancaire | |
validate | 14 | moteur de règles, identifiants, cohérence des montants, verdicts LLM corrigés, décision finale | |
rules | 8 | langage de conditions sûr, tables « premier match » explicables, escalade, machines à états | |
events | 11 | événements horodatés : fenêtres, veille des événements attendus, sessions, transitions de statut | |
analytics | 18 | analyses supply chain sans pandas : demande, ruptures, taux de service, stock de sécurité | |
| Restituer | export | 8 | CSV pour Excel FR, classeurs Excel partagés, rapports HTML / Markdown / PDF |
report | 6 | écarts persistables, synthèses, file de revue | |
render | 12 | livrables HTML : diagrammes Mermaid pré-rendus, graphiques ECharts, cartes GeoJSON | |
diagram | 6 | diagrammes de processus : lecture draw.io / BPMN JSON, rendu Mermaid et BPMN XML | |
| Exploiter | ops | 26 | haute disponibilité (battements, élection), démon à déclencheurs horaires, surveillance, contrôles préalables |
qa | 7 | non-régression rédactionnelle (fichiers dorés), rejeu de simulations, accord inter-annotateurs |
Recettes nommées
Chacune des 17 recettes est une liste YAML d’étapes nommées <famille>.<atome>. Trois exemples :
invoice_multi_doc: un lot de PDF multidocuments devient un ensemble de documents logiques contrôlés.io.collect→pdf.read→segment.documents→classify.documents→llm.extract→validate.ids→validate.amounts→validate.decide→export.csv→google.sheets.upsert→connect.notify. Chaque document finit valide, à vérifier ou invalide.doc_reconciliation: un dossier de factures, d’avoirs et de bons de livraison, contrôlé par rapport aux commandes. L’extraction LLM gardée (llm.extract_docs) est recoupée avec une extraction par motifs (extract.regex,compare.extractions,reconcile.fields), puis viennentcheck.documentetcheck.completeness, les lignes face à la commande (compare.reference), la chaîne commande → livraison → facture (reconcile.nway), et enfin un fichier d’écarts et une file de revue (report.discrepancies,report.review). 17 étapes.meeting_transcript: un enregistrement de réunion devient une transcription horodatée avec locuteurs.audio.decode→audio.vad→audio.transcribe→audio.diarize→audio.speakers→audio.segments→export.csv→export.transcript→connect.notify.
Les autres sont notamment delivery_vs_order, ledger_reconciliation, invoice_dedup,
article_base_cleaning, stock_policy, mail_to_sheet, draft_mails,
pdf_text_extract, rubric_eval, screen_session, camera_flow et
process_from_transcript.
L’Atlas
L’Atlas est une page HTML unique, consultable hors ligne, générée à partir du code lui-même (arbres syntaxiques et YAML), sans aucune donnée saisie à la main. Il dessine le catalogue comme un tableau périodique : chaque famille est un élément doté d’un symbole, chaque module un atome, chaque recette une molécule. Il signale aussi les atomes sans documentation, sans test ou sans exemple d’usage.
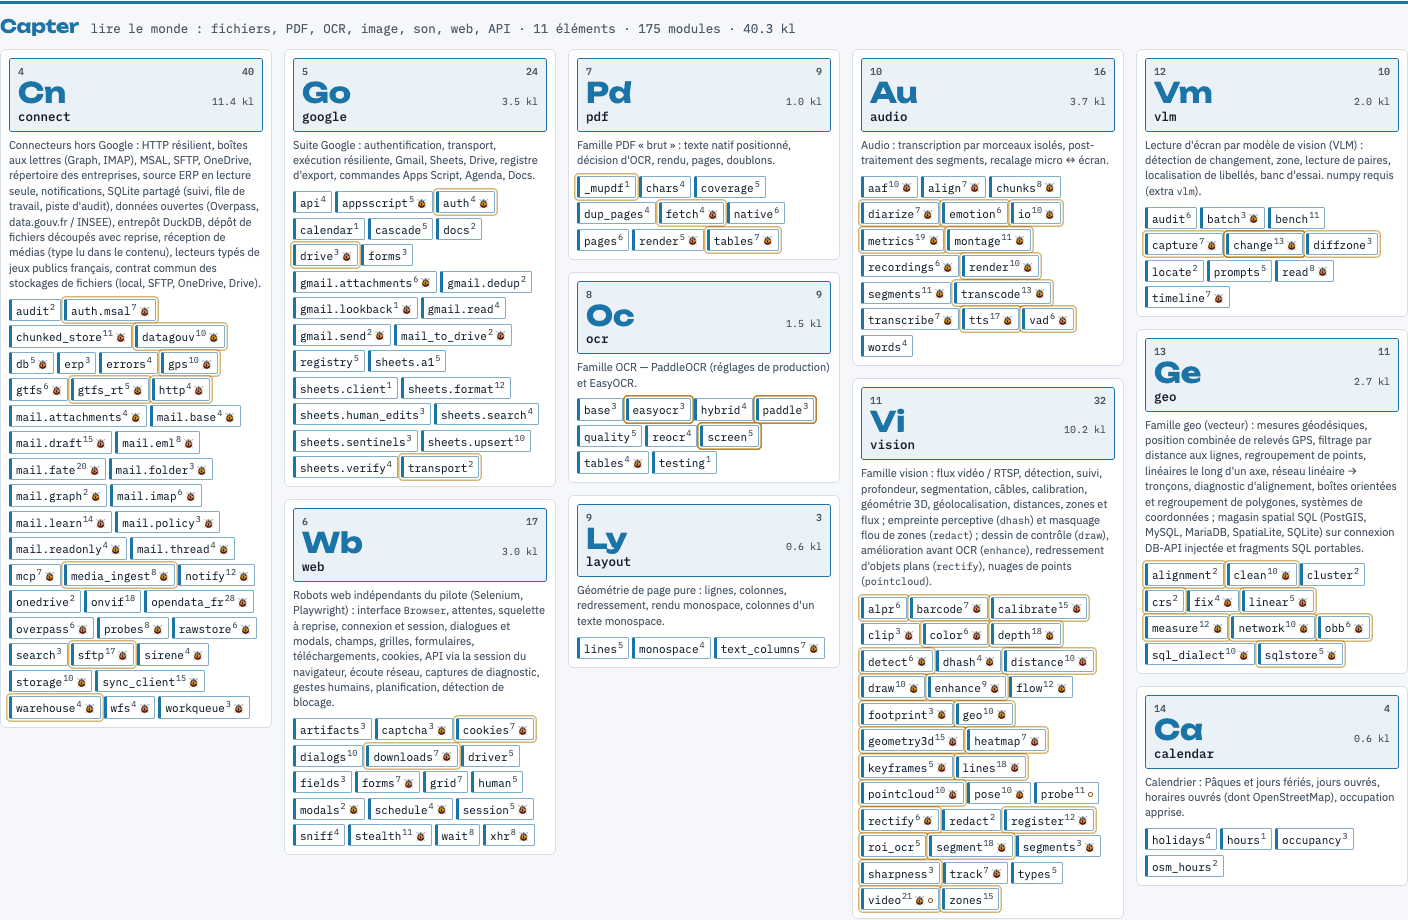 La série « Capter » du tableau périodique. Chaque case est une famille, avec son symbole, son nombre de modules et sa taille en milliers de lignes ; chaque tuile en dessous est un atome.
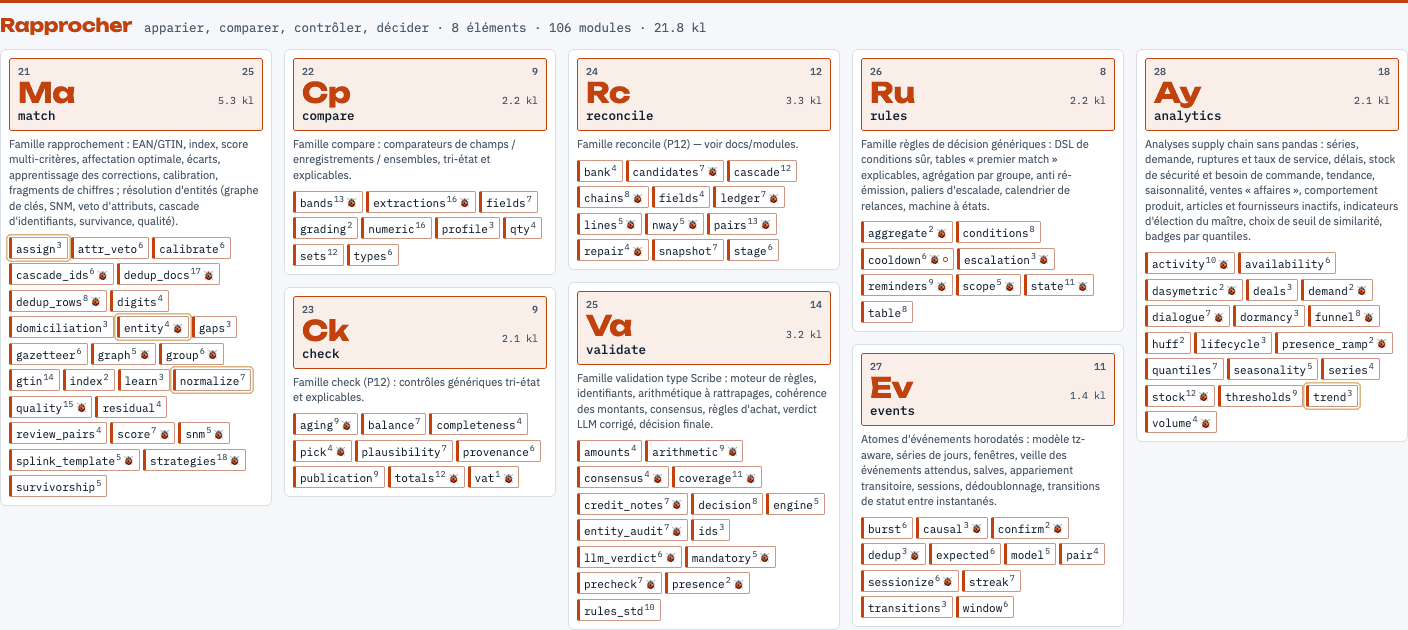 La série « Rapprocher » : les familles qui apparient, comparent, contrôlent et décident.
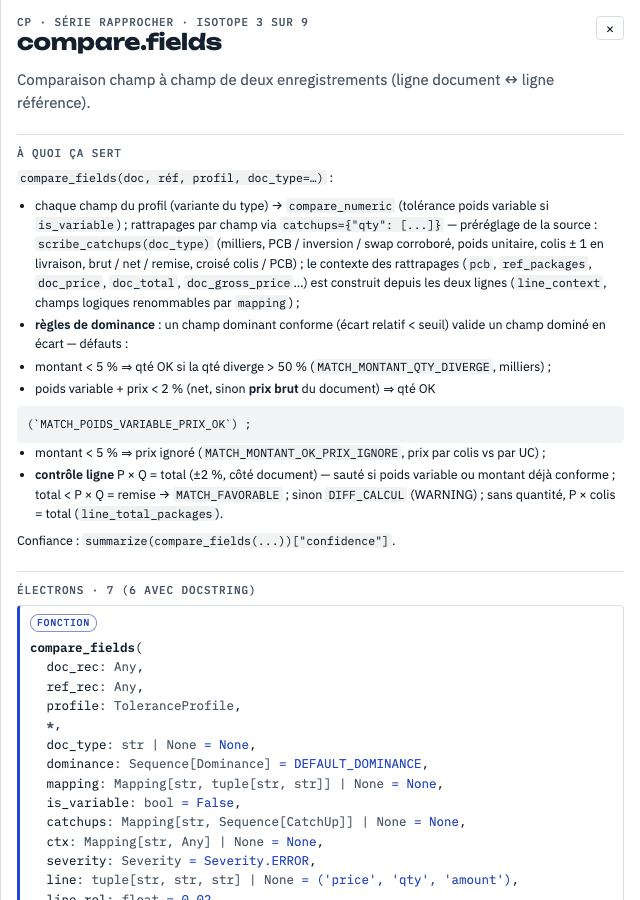 La fiche d’un atome (
compare.fields) : à quoi il sert, d’après sa docstring, puis chaque nom public avec sa signature complète.
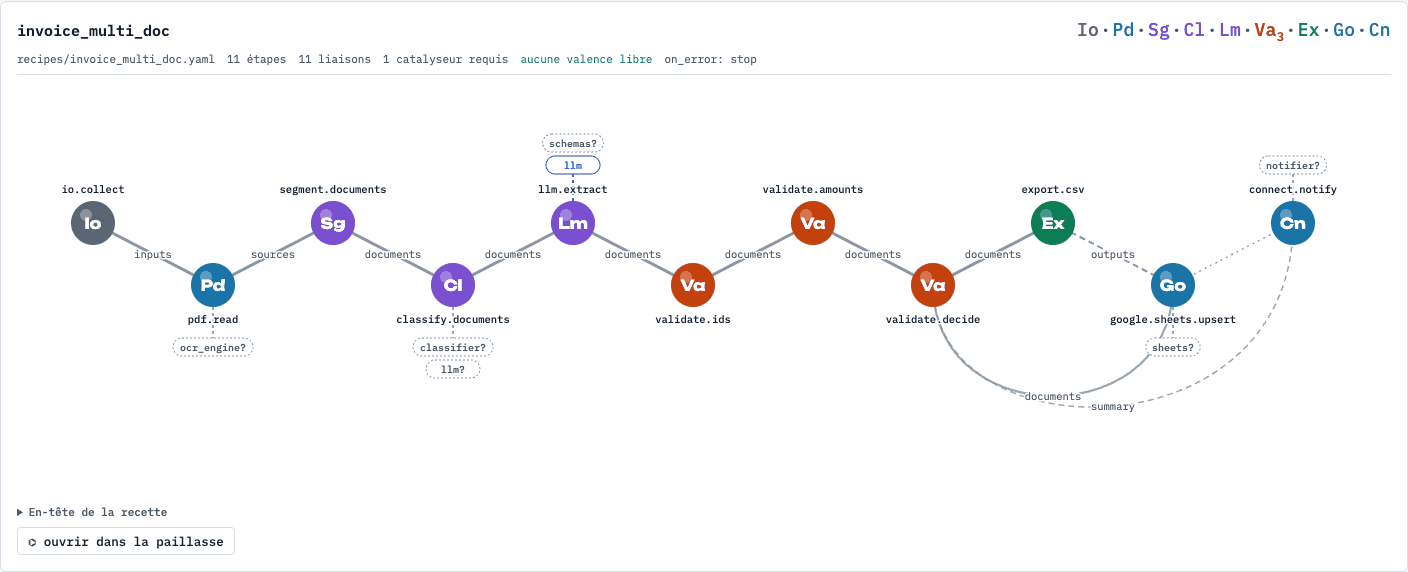 La recette
invoice_multi_doc en molécule : 11 étapes, les clés de contexte qui les relient et les services requis (en pointillé lorsqu’ils sont facultatifs).
Méthodes
- Résultats tri-états. Chaque comparaison renvoie
ok ∈ {True, False, None}(conforme / écart / non concluant) avec un code de motif nommé et une trace. Une valeur manquante ou illisible compte comme non concluante, jamais comme une anomalie. Les résultats non concluants sont tout de même comptabilisés, et non écartés en silence. - Routage hybride texte natif/OCR. Chaque page PDF est classée comme native, OCR ou vide, selon la quantité de texte natif qu’elle contient et la part de ce texte couverte par des images. L’OCR n’est exécuté que là où il est nécessaire.
- Extraction LLM ancrée. L’extraction JSON structurée est validée par rapport à des schémas Pydantic. Chaque valeur extraite est ensuite vérifiée mot pour mot dans le texte source, de sorte que les valeurs altérées ou inventées sont signalées.
- Rapprochement inter-documents. Factures, bons de livraison et commandes sont comparés ligne à ligne à l’aide de tolérances nommées et de règles de dominance. Par exemple, un montant de ligne concordant peut l’emporter sur un écart de prix.
- Provenance. Chaque atome porté comporte un en-tête
Provenance:et une entrée qui le relie àrepo@commit:path:linesdans le code de production d’origine. Les bogues découverts lors du portage ont été corrigés, et chaque correction est couverte par un test de non-régression. - Architecture contrôlée. Le découpage en couches est vérifié par 30 contrats d’import :
un atome n’importe que le paquet
core. Un typage strict, un seuil de couverture ≥ 80 % et une vérification de l’absence de noms de clients dans le code source sont également imposés. - Abstraction du matériel. Les atomes de vision et d’audio ciblent
cuda,mpsoucpuvia un seul paramètre. - Évaluation de bout en bout. Les tests s’exécutent avec de vrais moteurs (PaddleOCR, Ollama
qwen3:8betqwen3-vl:8b) sur des données à vérité terrain connue. Chaque métrique est consignée face à un seuil dans un rapport JSON/HTML. Les métriques qui n’atteignent pas leur seuil sont conservées et affichées comme en échec.
Résultats
Base de code (arborescence actuelle) : 459 modules d’atomes répartis en 32 familles, 77 étapes paramétrées, 17 recettes YAML, 30 contrats d’import. La suite collecte 2 959 tests unitaires et de recettes, plus 109 tests de bout en bout exécutés séparément. Les 17 recettes disposent toutes d’au moins un test de bout en bout, et 34 des 35 éléments de l’Atlas sont testés de bout en bout.
Scores de bout en bout sélectionnés (documents synthétiques à vérité terrain connue, modèles 8B locaux) :
| Tâche | Moteur | Mesure |
|---|---|---|
| Rapprochement facture + bon de livraison / commande | qwen3:8b | types de documents et champs 14/14 ; écarts attendus 5/5 ; 0 faux écart sur le cas conforme |
| Extraction JSON par LLM (4 factures natives) | qwen3:8b | JSON valide 4/4 ; champs exacts 28/28 ; toutes les valeurs volontairement altérées détectées par l’ancrage |
| OCR sur une étiquette photographiée | PaddleOCR | rappel des mots 0,94 sur la photo brute ; un défaut de rehaussement du contraste (0,65–0,71) a été identifié et corrigé (0,88–0,94) |
| Reconstruction de tableaux à partir de l’OCR | PaddleOCR | 100 % de cellules exactes (police proportionnelle), 95 % (chasse fixe) |
Limites & suite
- L’ancrage verbatim ne peut pas détecter une valeur présente dans le document mais placée dans le mauvais champ : un champ absent a été rempli à tort dans 1 cas sur 8.
- Le modèle 8B a jugé un écart de quantité de +50 % comme un écart « mineur », contrairement à la consigne. Les verdicts du LLM sont donc normalisés et maintenus en aval de règles déterministes.
- Les scores proviennent principalement de données synthétiques. Un jeu de test sur documents réels est en cours de constitution en dehors du dépôt, et seuls les cas ayant fait l’objet d’une revue sont notés.
- Prochaines étapes : mesurer le taux de rapprochement automatique et le taux de faux positifs sur des données de production.
Stack technique
Python · Pydantic · PyYAML · PaddleOCR · Ollama (qwen3:8b, qwen3-vl:8b) · Mistral / Anthropic / OpenAI APIs · pytest · mypy · import-linter · ruff