Contexte
Une conférence enregistrée sur plusieurs microphones (intervenants, salle, musique) produit des heures d’audio multipiste brut. L’essentiel du temps de montage est consacré à repérer la matière — qui parle quand, sur quelle piste, où se trouvent les silences — avant toute coupe.
Les outils vocaux open source (Whisper et ses dérivés, pyannote, Silero VAD) résolvent bien la transcription et la question « qui a parlé quand », mais s’arrêtent au texte. La question traitée ici est de savoir si cette analyse peut être livrée sous la forme d’un objet de montage : une timeline multipiste au format AAF, le format d’échange que les stations audionumériques ouvrent nativement, avec des pistes qualifiées et les temps morts supprimés.
Avant → après
Un vrai projet traité de bout en bout : une conférence enregistrée sur 16 pistes. Toute la colonne de droite est produite automatiquement, sans aucune coupe manuelle ; les chiffres sont lus dans la base d’analyse du projet et dans l’AAF livré.
| Entrée (enregistrement brut) | Sortie générée (timeline AAF) | |
|---|---|---|
| Pistes | 16 × 1 h 32 min 54 s (≈ 24 h 46 min d’audio à parcourir) | 16 pistes conservées dans l’AAF, dont 6 portent des clips |
| Rôles des pistes | 4 parole · 2 musique (dont une détectée comme ambiance) · 10 silencieuses | 10 pistes silencieuses laissées vides, sans tri manuel |
| Matière | 204 régions de parole et 5 passages musicaux détectés | 41 clips (37 parole, 4 musique) |
| Coupes | — | 40 coupes franches entre sources, dont 33 changements de micro |
| Transitions | — | 0 fondu enchaîné : coupes franches, chaque clip de parole prolongé de 0,3 s |
| Temps morts | — | 3 trous ≥ 4,5 s supprimés en ripple (36,9 s) ; timeline de 1 h 32 min 17 s |
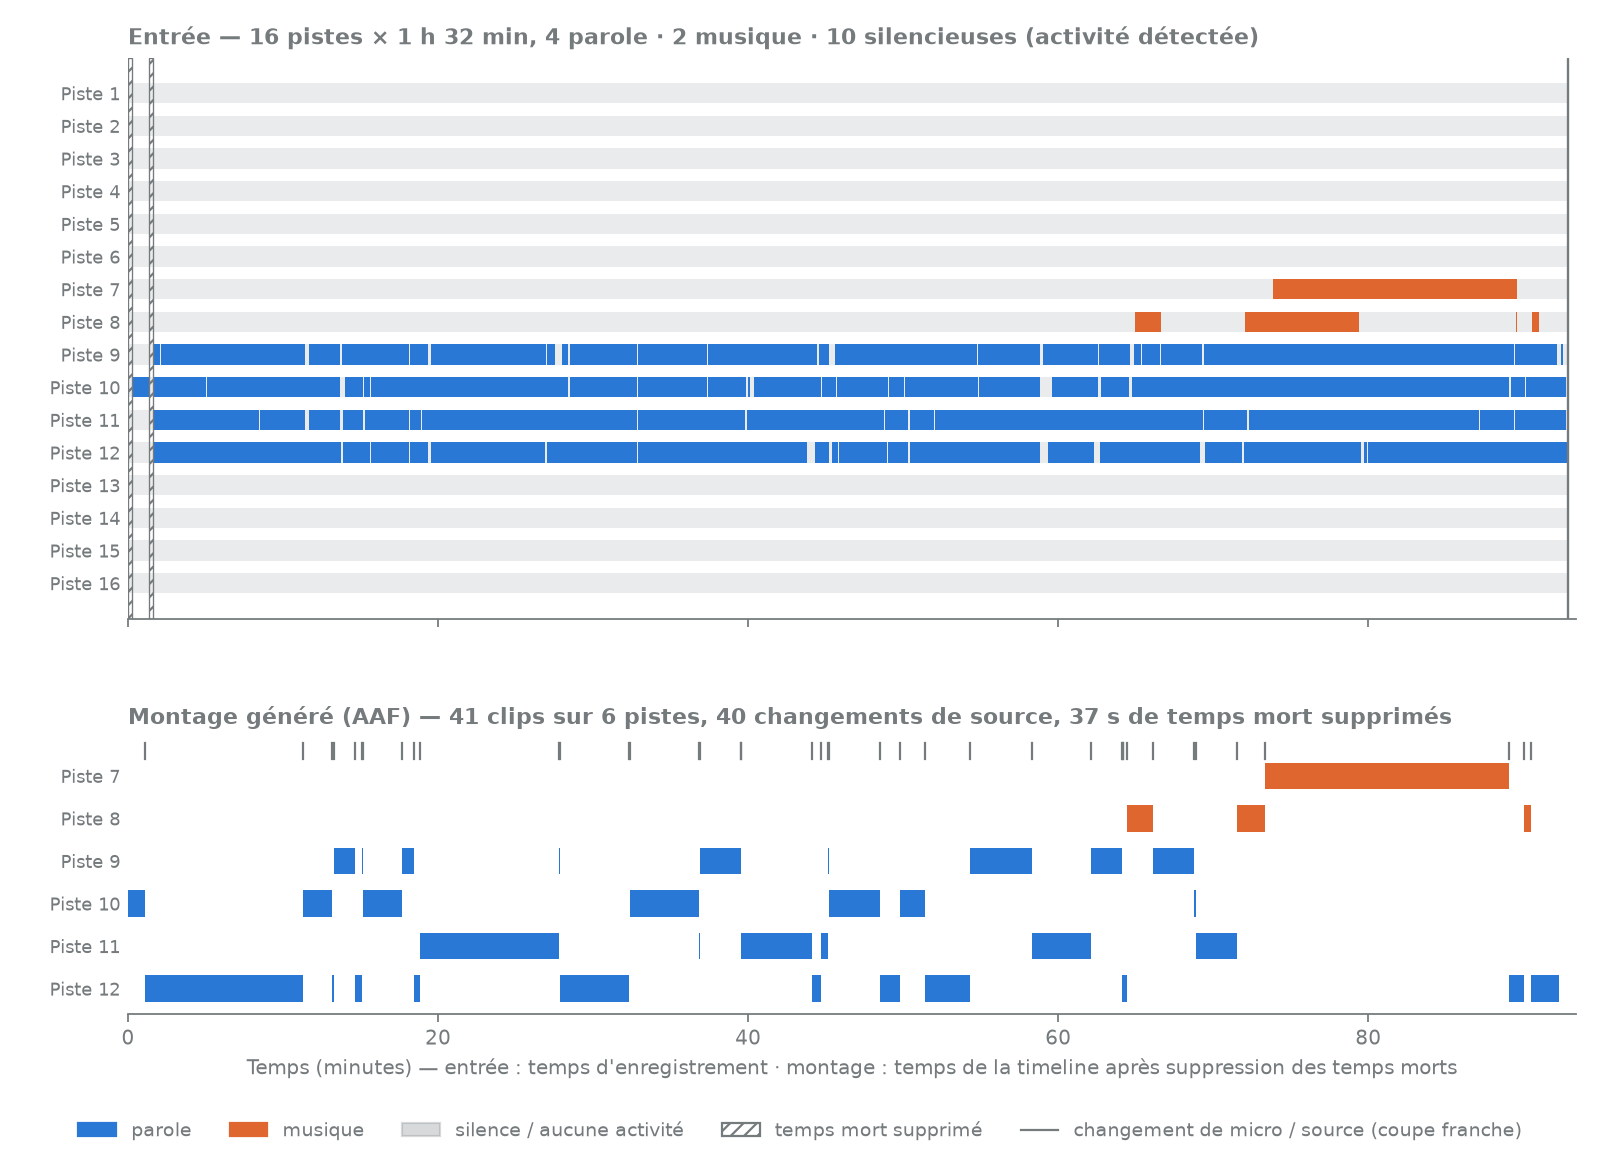
En haut : les 16 pistes d’entrée sur toute la durée de l’enregistrement, colorées selon le rôle et l’activité détectés ; les quatre micros de parole sont actifs presque en permanence, car chacun capte aussi ses voisins. En bas : le montage généré, une ligne par piste comme dans l’AAF — une seule source est retenue à chaque instant, les repères marquent les 40 changements de source, les zones hachurées du panneau supérieur sont les temps morts supprimés.
Les clips de parole sont peu nombreux et longs (médiane 79 s, le plus long 10 min 11 s) : le montage suit l’intervenant actif au lieu de couper à chaque respiration, et les micro-bascules de moins de 0,8 s sont absorbées par le lissage anti-scintillement. Dix clips durent encore moins de 6 s — de brèves interjections, premier endroit à vérifier lors de la relecture du montage.
Approche
Méthodes
Transcription. Whisper large-v3 via faster-whisper (CTranslate2), exécuté
sur des segments de longueur fixe dans un processus de travail isolé et
persistant : le modèle n’est chargé qu’une fois, et un plantage natif ne fait
perdre qu’un segment, signalé plutôt qu’ignoré silencieusement. Le décodage
utilise une recherche en faisceau avec filtrage Silero VAD, et
condition_on_previous_text est désactivé pour limiter les boucles de
répétition.
Horodatage des mots et locuteurs. Les horodatages au niveau du mot proviennent de l’alignement forcé de WhisperX (wav2vec2). Les tours de parole proviennent de la diarisation pyannote et sont attribués aux mots par recouvrement temporel.
Post-traitement. Des filtres purs suppriment les hallucinations connues de Whisper (crédits de sous-titrage types, formules du genre « merci d’avoir regardé », segments purement musicaux), les sorties en écriture non latine sur de l’audio français et les doublons, puis fusionnent les segments consécutifs d’un même locuteur.
Qualification des pistes et montage. Chaque piste est classée en parole, musique ou silence en combinant l’énergie par trame, la couverture VAD et des statistiques de transcription. Le montage sélectionne, pour chaque trame de 100 ms, le microphone présentant le meilleur rapport signal sur bruit au-dessus de son propre bruit de fond (ce qui réduit la diaphonie entre micros), applique un lissage anti-papillotement et resserre la timeline en supprimant les temps morts globaux.
Synchronisation. Les enregistreurs distincts sont alignés en appariant des mots caractéristiques entre transcriptions (médiane robuste des décalages), après un placement grossier fondé sur l’horloge et corrigé de la dérive d’horloge.
Export. La liste de montage est écrite sous forme d’AAF multipiste avec
pyaaf2, en intégrant l’audio ou en le référençant.
Déploiement. Un portail web reçoit les tâches et un nœud de calcul distinct l’interroge en HTTPS. Les clients ne téléversent que des copies d’analyse compressées accompagnées d’un manifeste de leurs fichiers d’origine ; l’AAF livré référence les noms des WAV d’origine, de sorte que le monteur reconnecte localement les sources en pleine qualité et que les originaux ne quittent jamais la machine du client.
Résultats
Banc d’essai (bench_stt.py) sur de l’audio réel de conférence : fenêtres de
parole d’une minute sélectionnées par VAD sur quatre pistes de parole, Whisper
large-v3 dans tous les cas, ordinateur portable Apple Silicon, mesures à
chaud hors chargement du modèle. Aucune transcription de référence n’étant
disponible, les indicateurs de qualité sont des divergences par rapport à
une pseudo-référence (sortie de WhisperX), et non des erreurs absolues.
| Chaîne de traitement (CPU) | Facteur temps réel |
|---|---|
| openai-whisper | 0,43 |
| WhisperX | 0,51 |
| WhisperX + alignement forcé | 0,54 |
| openai-whisper + horodatage des mots | 0,57 |
| faster-whisper (faisceau 5 + VAD) | 0,66 |
| faster-whisper + horodatage des mots | 0,70 |
- Horodatage des mots : les horodatages natifs s’écartent de l’alignement forcé d’environ 205 ms en médiane (faster-whisper) et d’environ 210 ms (openai-whisper) ; l’alignement forcé ajoute environ 1,2 s par minute d’audio.
- Divergence des transcriptions : 7 à 11 % de divergence au niveau du mot entre chaînes, essentiellement de la ponctuation, de la segmentation et de la normalisation après inspection manuelle.
- Répétitions : 1 à 2 % de contenu répété ; aucun passage halluciné observé sur ces extraits.
- Détection des pistes : les trois pistes de musique ou de silence de l’enregistrement à sept pistes ont été identifiées par VAD et écartées automatiquement.
Limites & suite
- La qualité est mesurée par rapport à une pseudo-référence ; un jeu de test transcrit manuellement est nécessaire pour rapporter un véritable taux d’erreur sur les mots et un taux d’erreur de diarisation.
- Les extraits du banc d’essai sont courts (une minute par piste) et ne comportent qu’un seul locuteur par fenêtre : la précision de la diarisation en cas de chevauchement de plusieurs locuteurs n’est donc pas encore quantifiée.
- CTranslate2 n’a pas de backend Metal : sur Apple Silicon, faster-whisper et WhisperX s’exécutent sur CPU, tandis que CUDA est utilisé lorsqu’il est disponible. Le choix du matériel pour chaque étape a été mesuré plutôt que présumé ; une comparaison sous CUDA reste à effectuer.
- L’export AAF cible l’import dans Logic Pro ; les autres logiciels de montage n’ont pas été testés de manière systématique.
Stack technique
Python · faster-whisper · CTranslate2 · WhisperX · pyannote.audio · Silero VAD · PyTorch (MPS / CUDA) · ffmpeg · pyaaf2 · SQLite · PHP · MySQL